直接回答:InfluxDB 里 bucket 类似关系库的库、measurement 类似表、point 类似行;tag 是带索引、取值有限且不常变的元数据,field 是真正的测量值,查询时只对 tag 和 field 做过滤要用两种不同写法。
InfluxDB 数据模型将时间序列数据组织到存储桶和测量中。一个桶可以包含多个测量值。测量包含多个标签和字段。
bucket(存储桶):存储时间序列数据的指定位置。一个桶可以包含多个测量值。也就是类似关系型数据库中的库,举例:家
measurement(度量):时间序列数据的逻辑分组。给定测量中的所有点都应具有相同的标签。一个测量包含多个标签和字段。也就是类似关系型数据库中的表,举例:能耗
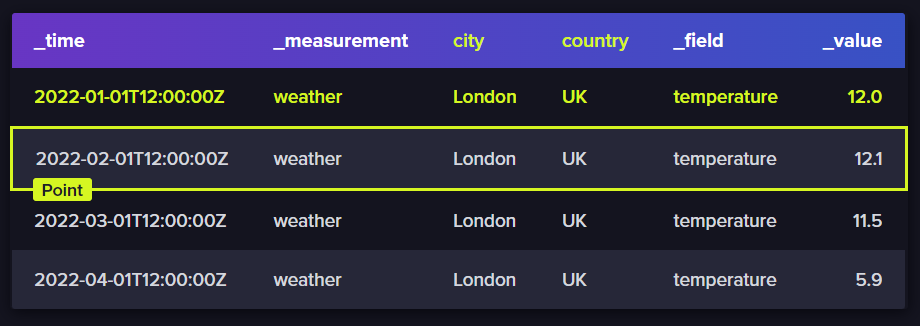
point(数据端点):通过测量、标签键、标签值、字段键和时间戳来标识的单个数据记录。也就是类似于关系型数据库中的行
Tags,举例:空调
(键值对):其值不同,但不经常更改。标签用于存储每个点的元数据
- - 例如,用于识别数据源(如主机、位置、站点等)的东西。
field(字段):键值对,其值随时间变化,例如:温度、压力、股票价格等。
Timestamp(时间戳):与数据关联的时间戳。当存储在磁盘上并查询时,所有数据都按时间排序。
measurement:
1
home
- tags 标签
room: Living Room or Kitchenroom:客厅或厨房
- fields 字段
temp: temperature in °C (float)temp:温度,单位℃(浮子)hum: percent humidity (float)hum:百分比湿度(float)co: carbon monoxide in parts per million (integer)co:一氧化碳,单位为百万分之一(整数)
- timestamp: Unix timestamp in second precisiontimestamp:秒精度的Unix时间戳
测量:
home- tags 标签
1 | home,room=Living\ Room temp=21.1,hum=35.9,co=0i 1641024000 |
时序数据库,主键永远是时间time(自动生成的)。
database
数据库。
measurement
数据库中的表。
points
表里面的一行数据。根据timestamp+series保证唯一。
points由:
measurement
标签(tags):有索引的属性 数据(field):没有索引的属性 timestamp 组成。
每个point就是时间轴上的一个点;tag用来检索;field用来记录信息,measurement用于将相同类型的数据归集。
series
一个series就是一个测点,或者说一条曲线,retention policy, measurement, tagset就共同组成了一个定位测点序列的唯一标识,这三者有多少种组合就有多少个series。
point就是某个series的同一个时刻的多个field的value,也就是一般曲线上的一个点。
InfluxDb不需要做schema定义,这意味着你可以随意的添加measurements, tags, fields。
单从tag角度思考,有几种tag组合就有几个series,tag有索引作为分类标准就清楚了。
continuous queries持续查询
retention policy存储策略
1 | show retention policies on db_xxx #查看数据保留策略 |
数据订阅 subscription
1 | show subscriptions #查看订阅 |
数据库查看
1 | show databases |
measurement查看
1 | show measurements |
一个查询语句
1 | client := MyInfluxDB.GetInfluxClicen() |
序列查看
1 | show series |
存储策略查看
1 | show retention policies |
标签key查看
1 | show tag keys |
标签取值查看
1 | show tag values |
字段key查看
1 | show field keys |
更多 schema操作
数据库操作
新建数据库
1 | create database |
删除数据库
1 | drop database |
删除序列
1 | drop series |
删除度量
1 | drop measurement |
删除分片
1 | drop shard |
删除数据点
1 | delete |
存储策略
创建
1 | create retention policy |
修改
1 | alter retention policy |
删除
1 | drop retention policy |
这篇笔记整理自我自己的实践记录,如果做法有出入,或者你踩过别的坑,欢迎到留言板一起聊聊。
